Brute force protection: l'autenticazione che non cede
-
- Sviluppo |
- Giugno 2026 |
- 04 Min di lettura
Gli attacchi brute force non si basano sull’ingegno ma sulla ripetizione. Un’automazione prova sistematicamente combinazioni di credenziali una dopo l’altra finché non trova quella giusta. Non c’è bisogno di intercettare il traffico di rete né di sfruttare una vulnerabilità complessa nel codice applicativo. L’unica cosa che serve è un form di login che risponde e tempo a disposizione. Per questo motivo la protezione contro questa categoria di attacchi è considerata un requisito di base nella stragrande maggioranza degli standard di sicurezza moderni, tra cui la ISO 27001, e rappresenta uno dei controlli più facili da trascurare quando l’attenzione del team è concentrata sulle funzionalità.
Il meccanismo dell’attacco
Un attacco brute force classico tenta ogni combinazione possibile di caratteri fino a trovare la password corretta. Nella pratica questa variante è raramente usata su sistemi esposti perché richiederebbe un tempo computazionale proibitivo. Ciò che compare frequentemente nei log di produzione è piuttosto un attacco a dizionario, in cui l’automazione prova sequenzialmente le password più comuni, quelle trapelate in precedenti breach o ricavate da informazioni pubbliche sull’utente bersaglio. La variante più subdola è la credential stuffing: si prendono le coppie email e password provenienti da un database compromesso di un altro servizio e le si verifica sistematicamente su quello che si intende attaccare. Questo funziona perché molti utenti riusano le stesse credenziali su servizi diversi, e l’attaccante lo sa bene.
I meccanismi di difesa
La prima linea di difesa è il rate limiting. Limitare il numero di tentativi di login consentiti in un determinato intervallo di tempo da uno stesso indirizzo IP riduce drasticamente la velocità con cui un attaccante può operare. La soglia va calibrata con attenzione perché troppo permissiva rende la protezione inefficace, troppo restrittiva rischia di bloccare utenti legittimi in situazioni di mobilità o dietro proxy aziendali. Una strategia comune è l’introduzione di un ritardo progressivo tra i tentativi falliti, il cosiddetto exponential backoff, che rende il processo iterativo sempre più lento senza creare una barriera assoluta.
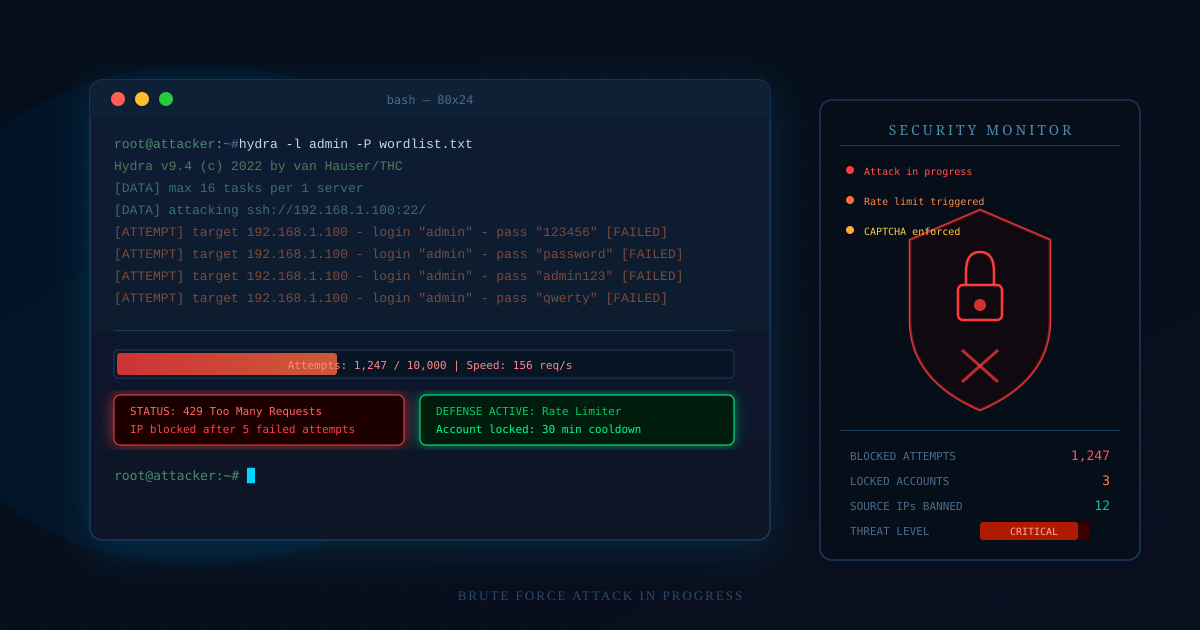
Il blocco temporaneo dell’account dopo un certo numero di tentativi falliti è un altro strumento consolidato, ma va gestito con consapevolezza perché introduce un vettore secondario: un attaccante che conosce gli username degli utenti potrebbe deliberatamente innescare i blocchi per causare una negazione del servizio distribuita. Per questo motivo molti sistemi affiancano al blocco per account un blocco per IP con soglie differenziate e procedure di sblocco che non possano essere automatizzate. I CAPTCHA, pur imperfetti e spesso frustranti per l’utente, aggiungono un ulteriore livello di attrito che rende antieconomica l’esecuzione automatica su larga scala.
Token, sessioni e autenticazione multifattore
La protezione più robusta contro il brute force non è tecnica ma architetturale. Un sistema che richiede un secondo fattore di autenticazione, che sia un codice temporaneo su un’app dedicata o una notifica push, rende inutile qualunque attacco sulle credenziali perché la conoscenza della password da sola non è sufficiente per completare l’accesso. L’autenticazione multifattore non elimina la necessità di proteggere il form di login, ma riduce in modo radicale il danno potenziale nel caso in cui le credenziali siano effettivamente compromesse.
La gestione dei token e delle sessioni è un’area spesso trascurata nella valutazione della superficie d’attacco. Token con scadenza breve, meccanismi di revoca esplicita e invalidazione automatica delle sessioni inattive riducono la finestra temporale in cui un token rubato può essere riutilizzato. Nel contesto di API esposte, l’uso di meccanismi di firma delle richieste garantisce che anche un token intercettato non possa essere replicato senza che la firma risulti invalida.
Il ruolo del logging nella risposta agli incidenti
Un sistema di autenticazione che respinge gli attacchi senza registrare ciò che accade è cieco di fronte alle minacce in evoluzione. Il logging granulare dei tentativi di login falliti, completo di timestamp, indirizzo IP, user agent e account bersaglio, non serve solo a soddisfare requisiti formali di conformità ma è il materiale grezzo su cui si costruisce la risposta agli incidenti. Senza di esso è impossibile stabilire se un accesso avvenuto in un dato momento fosse legittimo o il risultato di un attacco riuscito dopo centinaia di tentativi falliti nelle ore precedenti.
La correlazione di questi eventi nel tempo è ciò che permette di distinguere un utente smemorato che ha dimenticato la password da un’automazione che sta testando diecimila combinazioni nell’arco di un’ora. I sistemi di alerting devono essere configurati per rilevare anomalie di volume e pattern, non solo soglie assolute, perché un attacco distribuito su più indirizzi IP può aggirare facilmente una regola che conta i fallimenti per singola sorgente.
La prospettiva ISO 27001
Il controllo A.9.4.4 della ISO 27001 richiede esplicitamente che i sistemi implementino misure per prevenire gli accessi non autorizzati attraverso tentativi ripetuti. Non prescrive implementazioni specifiche ma definisce l’obiettivo: il sistema deve rendere economicamente e operativamente impraticabile un attacco sistematico sulle credenziali. Questo si traduce nella necessità di documentare le scelte architetturali adottate, i parametri configurati e i criteri con cui sono stati stabiliti, in modo che possano essere valutati durante un audit.
Il controllo A.8.15, relativo al logging degli eventi, è complementare: senza una registrazione adeguata dei tentativi di accesso non è possibile dimostrare che la protezione è attiva né produrre evidenza forense in caso di incidente. Insieme, questi due controlli definiscono un perimetro di responsabilità che va dalla prevenzione al rilevamento, coprendolo in modo più completo di quanto farebbe ciascuno da solo.
Affrontare la protezione brute force come un problema di configurazione porta quasi sempre a soluzioni incomplete. La solidità di un sistema di autenticazione non deriva dall’attivare una funzionalità del framework ma dalla comprensione dei vettori di attacco reali, dalla calibrazione delle soglie in base al comportamento atteso degli utenti legittimi e dalla costruzione di una visibilità operativa che permetta di sapere, in tempo reale, se qualcosa di inatteso sta accadendo sul form di login.