Perché ignorare il package-lock è un suicidio architettonico?
-
- Sviluppo |
- Maggio 2026 |
- 04 Min di lettura
Esiste un errore silenzioso che si annida in molti repository moderni e che spesso viene spacciato per buona pratica di sviluppo: inserire il file package-lock.json nel gitignore. È il caso più diffuso nei progetti Node.js come React, Angular e Next.js, dove npm genera questo file automaticamente a ogni installazione. L’argomentazione è semplice e, in apparenza, ragionevole. Se le dipendenze sono già dichiarate nel file principale di configurazione del progetto, aggiungere al controllo di versione un altro file mastodontico e denso di hash sembrerebbe solo un inutile rumore di fondo nei diff. Questa convinzione, però, non è soltanto sbagliata dal punto di vista tecnico. Rappresenta un rischio concreto per la stabilità del prodotto, poiché smantella silenziosamente il principio fondamentale su cui si costruisce qualunque ambiente di sviluppo affidabile: la determinazione dell’ambiente stesso.
Il problema nascosto nei simboli di versione
Per comprendere davvero la portata del problema, è necessario capire come i gestori di pacchetti interpretano le dichiarazioni di dipendenza. Quando si definisce una libreria con il classico prefisso a cappelletto, si sta concedendo al sistema il permesso esplicito di scaricare versioni più recenti non appena queste vengono pubblicate dagli autori originali. Questo comportamento è per design, pensato per semplificare la ricezione di bugfix e patch di sicurezza, ma introduce una variabile che la maggior parte degli sviluppatori tende a sottovalutare: ogni installazione effettuata senza un file di blocco diventa potenzialmente diversa dalla precedente, con esiti impossibili da prevedere in anticipo.
Il problema si amplifica quando si considera la profondità dell’albero delle dipendenze. Un progetto di dimensioni moderate può avere decine di dipendenze dirette, ognuna delle quali ne porta con sé altre decine a cascata. Senza un meccanismo che fissi l’intera gerarchia in modo preciso e versionato, la composizione effettiva dei pacchetti installati dipende dal momento esatto in cui viene eseguito il comando di installazione. Lo sviluppatore che ha lavorato al codice due settimane fa e quello che lo clona oggi potrebbero ritrovarsi con alberi di dipendenze concretamente differenti, pur partendo dallo stesso file di configurazione.
I bug fantasma del deployment
Questa divergenza è la causa primaria di quei malfunzionamenti difficili da riprodurre che compaiono dal nulla durante il rilascio in produzione. Un aggiornamento minore di una libreria di terze parti, magari una dipendenza indiretta che nemmeno sappiamo di avere, può introdurre una regressione che rompe l’intera build sull’ambiente di produzione mentre tutto sembra funzionare perfettamente in locale. In questi casi, il problema non risiede nel codice applicativo scritto dal team, ma nella variabilità dell’ambiente sottostante che nessuno ha pensato di rendere esplicita e versionata.
In un’architettura professionale, la garanzia che il codice testato sia identico, bit per bit, a quello effettivamente rilasciato non è un lusso accessorio. È un requisito fondamentale di affidabilità, senza il quale ogni rilascio diventa un atto di fiducia cieca nei confronti di un ecosistema di pacchetti che cambia continuamente e che non ha alcun obbligo di notificarci le proprie modifiche. I team più maturi lo sanno bene: la riproducibilità dell’ambiente è la prima linea di difesa contro i downtime imprevisti, e il file di blocco è lo strumento più semplice e diretto per garantirla.
La dimensione invisibile della sicurezza
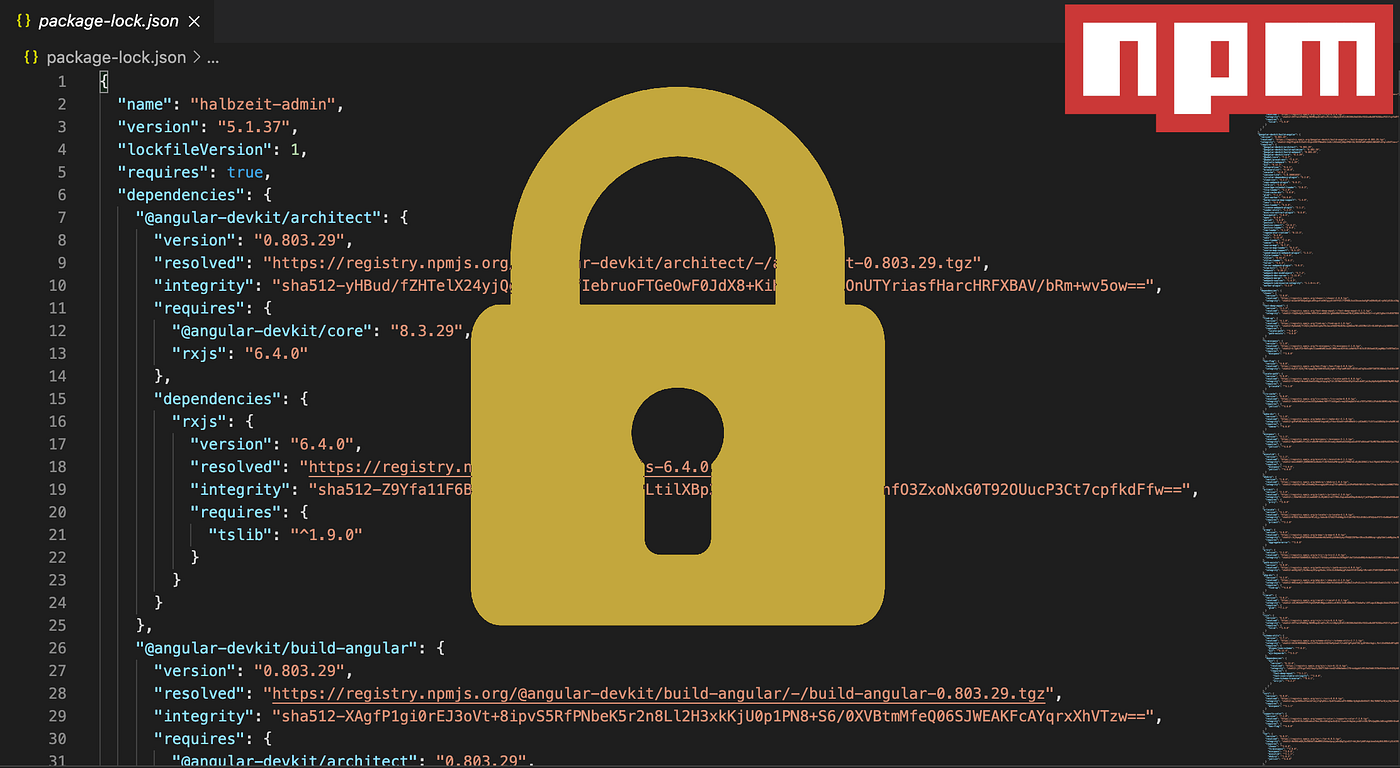
Oltre alla coerenza tra gli ambienti, il file di blocco assolve a una funzione critica nel campo della sicurezza informatica che spesso non viene considerata. Ogni voce al suo interno contiene un hash crittografico di integrità che garantisce che il pacchetto scaricato sia esattamente quello previsto, senza alterazioni avvenute durante il transito nella rete o direttamente nel registro dei pacchetti. Si tratta di uno scudo sottile ma essenziale contro gli attacchi alla supply chain del software, una categoria di minacce in forte crescita che punta a iniettare codice malevolo non nel progetto direttamente, ma nelle sue dipendenze.
Gli attacchi di questo tipo sono particolarmente insidiosi perché tendono a passare inosservati durante le normali fasi di sviluppo e revisione del codice. Un pacchetto compromesso che entra nell’albero delle dipendenze senza un controllo di integrità può propagare codice dannoso fino in produzione senza che nessun test automatico o revisione manuale lo intercetti. Ignorare il file di blocco significa rinunciare a questo livello di verifica, lasciando l’infrastruttura esposta a vettori di attacco che potrebbero non manifestarsi fino a quando il danno non è già stato fatto.
Dal caos al flusso deterministico
Il quadro che emerge da questa analisi è chiaro: il rumore visivo che un file di blocco genera nei commit è un prezzo irrisorio rispetto ai rischi che la sua assenza porta con sé. Gestire correttamente questo file significa compiere una transizione precisa, da una gestione approssimativa e non riproducibile a un flusso di lavoro deterministico in cui il comando di installazione non introduce variabili impreviste ma garantisce continuità rispetto all’ambiente già validato dal team.
Nelle pipeline di integrazione continua, questo principio si traduce nell’adozione di comandi specifici che ignorano le definizioni generiche di versione e forzano l’uso esclusivo del file di blocco. Questo approccio rappresenta lo standard consolidato per garantire che ogni build prodotta dall’automazione sia la replica esatta di ciò che il team ha sviluppato e testato. Adottarlo non richiede un ripensamento architetturale profondo, ma semplicemente la consapevolezza che ogni decisione sull’ambiente di esecuzione ha conseguenze che si propagano silenziosamente attraverso l’intera catena di rilascio, fino all’utente finale.