DeepSeek in locale: integrare un modello aperto nei SaaS senza pagare le API
-
- AI |
- Agosto 2026 |
- 05 Min di lettura
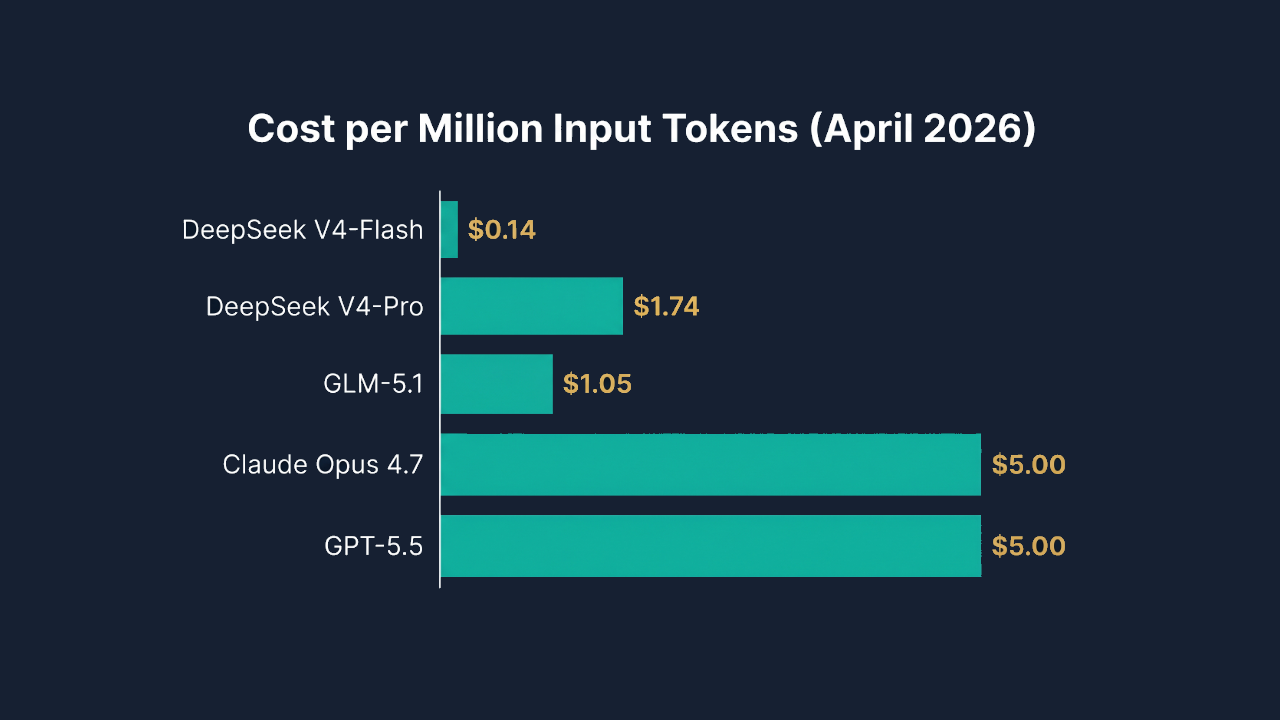
Quando un prodotto SaaS inizia a incorporare funzioni basate su modelli linguistici, la voce di costo legata alle API tende a crescere in modo silenzioso e poi improvvisamente evidente, perché ogni chiamata paga token in ingresso e in uscita e il conto scala linearmente con il numero di utenti attivi. DeepSeek, il modello aperto di origine cinese che negli ultimi mesi ha guadagnato attenzione per il rapporto tra qualità e dimensioni, offre una via alternativa a questo modello economico, dato che i suoi pesi sono scaricabili e la sua licenza consente di eseguirlo sulla propria infrastruttura. La domanda che ogni team tecnico dovrebbe porsi non è quindi se DeepSeek sia bravo quanto i modelli proprietari più celebri, ma se eseguirlo in locale cambi la struttura dei costi in modo abbastanza profondo da giustificare la complessità aggiuntiva.
Dal costo variabile al costo fisso
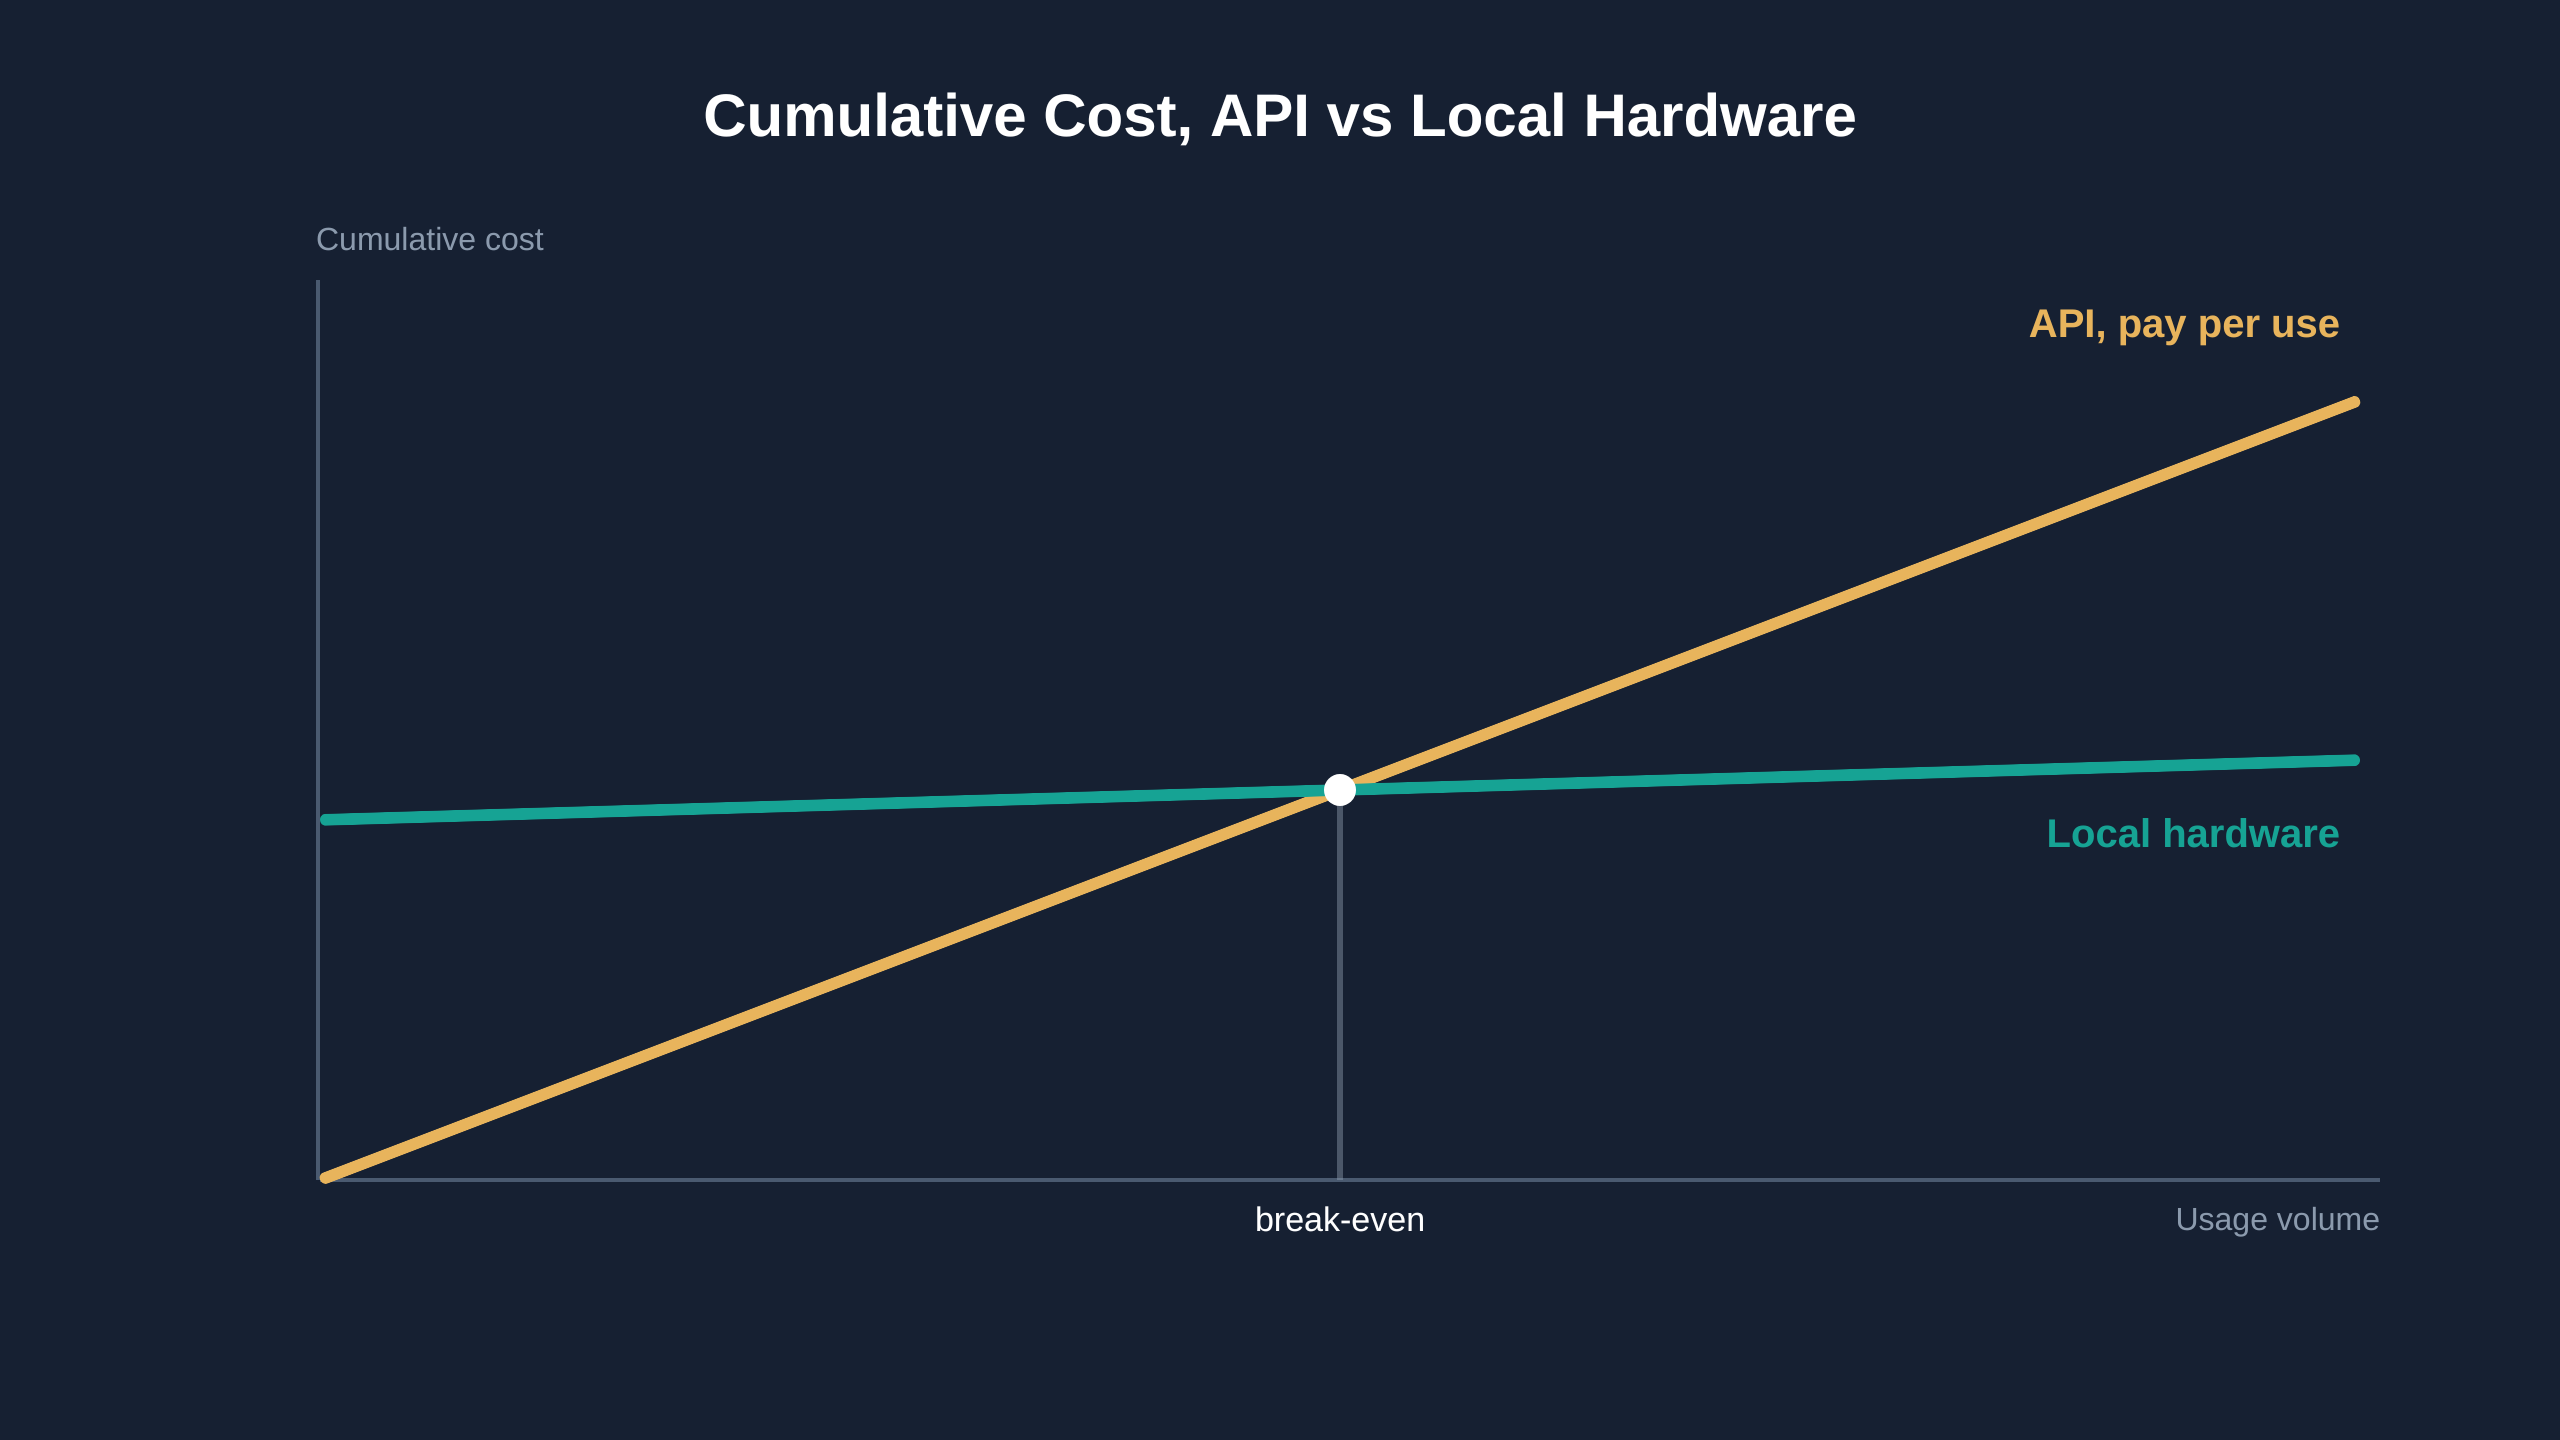
La differenza sostanziale tra usare un endpoint remoto e ospitare il modello sulla propria macchina è la trasformazione di un costo variabile in un costo fisso. Con le API ogni singola richiesta ha un prezzo, e per quanto quel prezzo possa essere basso il totale mensile dipende interamente dal volume di utilizzo, un volume che nei prodotti di successo tende a crescere proprio nel momento in cui i margini contano di più. Ospitare DeepSeek in casa rovescia questa logica, perché una volta pagato l’hardware l’inferenza aggiuntiva ha un costo marginale che tende a zero, fatta eccezione per l’energia elettrica. Il punto di pareggio esiste e va calcolato con onestà, dato che una macchina capace di far girare un modello di grandi dimensioni non è economica, ma per un SaaS con carichi costanti e prevedibili quel punto arriva prima di quanto si pensi, e da lì in poi ogni utente aggiuntivo non aumenta la bolletta delle API perché quella bolletta semplicemente non esiste.
Come si esegue davvero in locale
Eseguire un modello di queste dimensioni sulla propria macchina richiede alcune scelte tecniche che incidono direttamente sulla fattibilità. La più importante riguarda la quantizzazione, ovvero la riduzione della precisione con cui i pesi vengono memorizzati, che permette di far entrare in memoria modelli altrimenti troppo grandi accettando una perdita di qualità spesso trascurabile. Una quantizzazione a quattro bit consente a molte varianti di DeepSeek di girare su sistemi con memoria nell’ordine delle decine di gigabyte, mentre configurazioni più aggressive aprono la porta anche a macchine di fascia consumer con sessantaquattro gigabyte di RAM. Un secondo elemento decisivo è l’architettura a esperti, perché i modelli più recenti attivano soltanto una frazione dei propri parametri per ogni token generato, il che significa che un modello nominalmente enorme può comportarsi, in termini di velocità, come uno molto più piccolo. È questa sparsità a rendere possibile ottenere decine di token al secondo su hardware locale, una velocità sufficiente per un’esperienza fluida anche con contesti lunghi e con il tool calling attivo, a patto di usare i template corretti e di gestire con attenzione il budget di ragionamento del modello.
DeepSeek accanto a Claude, Gemini e OpenAI
Il confronto con i modelli più blasonati va fatto tenendo separate due dimensioni, la qualità pura e il modello di distribuzione. Claude, Gemini e i modelli di OpenAI restano riferimenti di eccellenza come generalisti, perché sono stati sottoposti a un fine tuning così attento da rispondere in modo equilibrato su quasi ogni compito, dalla traduzione letteraria al ragionamento complesso, e la loro affidabilità come agenti di coding è il frutto di un lavoro di allineamento difficile da replicare. Il loro limite, dal punto di vista di chi costruisce un SaaS, è che vivono dietro un’API a pagamento e dietro condizioni d’uso che nessuno controlla davvero. DeepSeek gioca un’altra partita, perché rinuncia a una parte di quella rifinitura generalista in cambio della possibilità di essere posseduto, ispezionato ed eseguito senza intermediari. Per molti prodotti questo compromesso è vantaggioso, perché il compito reale non è tradurre poesia ma classificare ticket, estrarre dati strutturati o assistere la scrittura di codice, ambiti nei quali un modello aperto ben scelto regge il confronto e in cambio elimina la dipendenza da un fornitore esterno.
Altri modelli locali da valutare
DeepSeek non è l’unica opzione in un panorama che si sta popolando rapidamente di pesi aperti degni di attenzione. La famiglia Qwen, sviluppata da Alibaba, copre un ventaglio di dimensioni che va dai modelli leggeri adatti a girare su un portatile fino a versioni molto capaci, ed è oggi uno dei riferimenti più solidi per chi vuole restare in locale. I modelli GLM offrono un’alternativa interessante con buone prestazioni sul ragionamento, mentre Mistral continua a produrre modelli europei compatti ed efficienti che si prestano bene a carichi di produzione contenuti. La linea Gemma di Google e i modelli Llama di Meta completano il quadro con ecosistemi maturi e un’ampia disponibilità di strumenti e quantizzazioni già pronte. La strategia più sensata, per un SaaS intelligente di nuova generazione, non è scegliere un modello una volta per tutte ma costruire un livello di astrazione che permetta di sostituire il motore sottostante, così da poter adottare rapidamente il modello aperto migliore man mano che il panorama evolve.
Quando l’indipendenza vale il suo prezzo
La scelta di portare l’inferenza in casa non è mai puramente economica, perché porta con sé un valore che sul conto delle API non compare, ovvero l’indipendenza. Eseguire un modello in locale significa che i dati degli utenti non lasciano mai la propria infrastruttura, un requisito che in molti settori regolati non è un vantaggio ma una condizione necessaria. Significa anche non essere soggetti a limiti di frequenza, a cambi di prezzo unilaterali o alla deprecazione improvvisa di una versione su cui si era costruito un prodotto. Il prezzo da pagare è la complessità operativa, perché gestire un’infrastruttura di inferenza richiede competenze che l’API nasconde del tutto, dalla scelta della quantizzazione alla configurazione del grafo di esecuzione fino alla manutenzione dell’hardware. Per un progetto agli inizi, con volumi incerti, le API restano quasi sempre la scelta razionale, ma per un prodotto maturo con carichi stabili e requisiti di privacy stringenti, un modello aperto come DeepSeek eseguito in locale smette di essere un esperimento e diventa una decisione architetturale che ripaga nel tempo.