Sakana Fugu: quando il valore sta nell'orchestrazione, non nel modello
-
- AI |
- Luglio 2026 |
- 05 Min di lettura
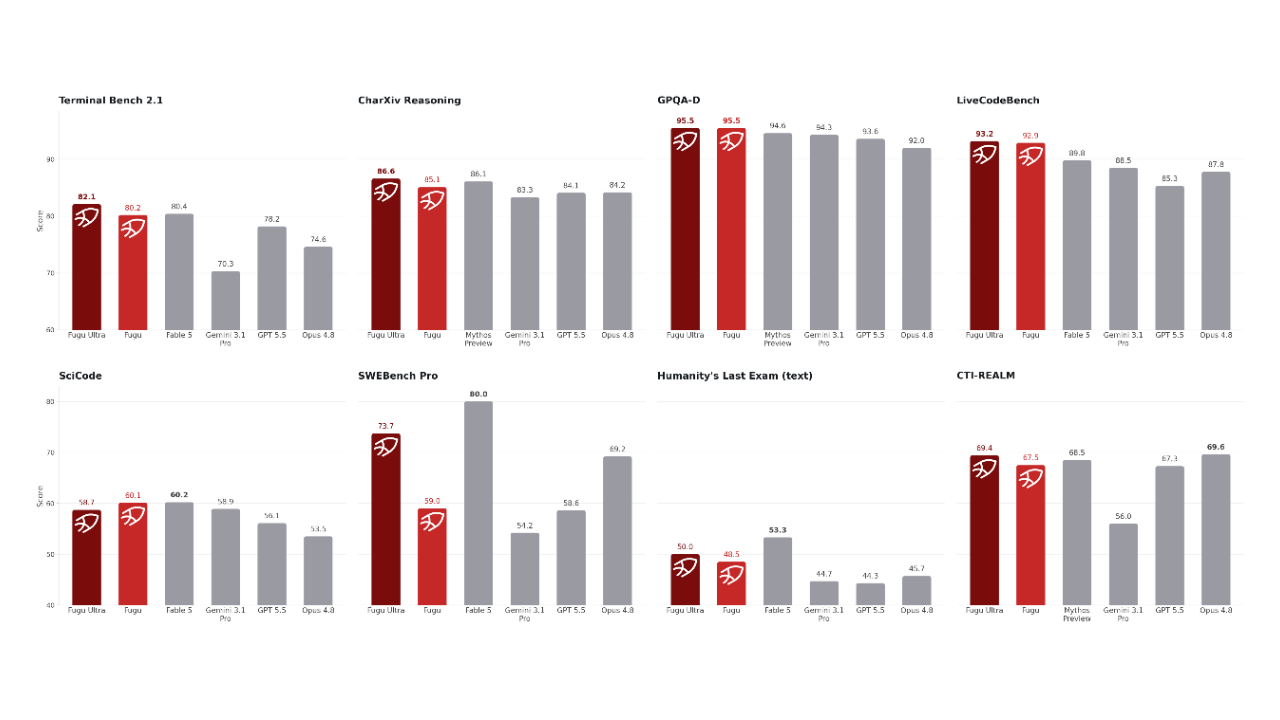
Per anni la corsa ai modelli di frontiera è sembrata una faccenda quasi esclusivamente tra Stati Uniti e Cina. Poi il Giappone si è presentato al tavolo con una mossa inattesa. Sakana AI ha annunciato Fugu e i primi benchmark hanno subito acceso i titoli, con prestazioni che superano Opus 4.8 e arrivano a sfiorare quelle dei modelli più recenti come Fable 5. La reazione immediata di molti commentatori è stata inquadrarlo come l’ennesimo modello più potente dei predecessori, e il pattern ormai familiare della corsa alla potenza computazionale sembrava ripetersi ancora una volta. La realtà è più interessante e, in un certo senso, più sovversiva. Fugu, che in giapponese significa pesce palla e prosegue la metafora acquatica di Sakana, letteralmente pesce, non è un modello nel senso tradizionale del termine. È un sistema che coordina altri modelli, ed è per giunta minuscolo.
Cosa fa davvero Fugu
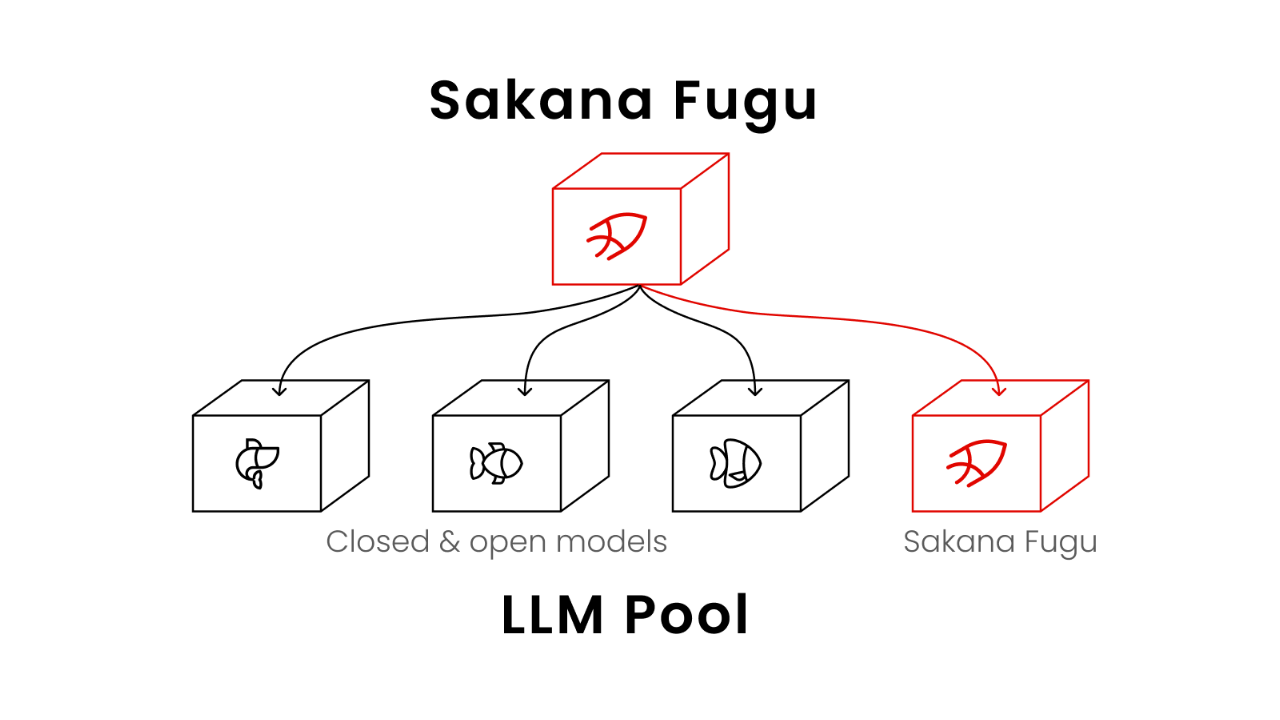
La distinzione non è tecnica ma concettuale, e vale la pena soffermarsi. Un modello linguistico classico riceve un input e produce un output attraverso i propri parametri, i miliardi di pesi che codificano le sue capacità. Fugu funziona in modo diverso, perché quando riceve una domanda non risponde con la propria intelligenza. Scompone la richiesta in componenti, identifica quale modello del suo insieme è più adatto a ciascuna parte, delega il lavoro, verifica i risultati incrociandoli tra loro e sintetizza una risposta unica. In pratica non esegue il lavoro, lo organizza. Il confronto con il general contractor del settore edile è calzante, perché il general contractor non posa i mattoni e non stende i cavi, ma garantisce che le persone giuste siano nel posto giusto al momento giusto e che il risultato finale sia coerente.
Il punto di partenza è quello che Sakana chiama LLM pool, un insieme di modelli messo a disposizione dell’orchestratore. In quella pool possono convivere modelli chiusi e modelli aperti, da Claude Opus a Gemini 3.1, da GPT a GLM, e Fugu è stato addestrato a scegliere, richiesta per richiesta, quale sia il più adatto. Sappiamo che alcuni modelli eccellono nella matematica, altri nella conoscenza generale, altri ancora nella scrittura di codice, e Fugu sfrutta la parte migliore di ciascuno invece di affidarsi a un solo cervello per qualunque compito.
Un modello piccolo che coordina i grandi
Il dettaglio che più sorprende è la dimensione. Fugu non è un gigante da centinaia di miliardi di parametri, è un modello da circa sette miliardi, piccolo per gli standard attuali, addestrato per un unico scopo, orchestrare. Non deve contenere la conoscenza del mondo, deve solo sapere a chi rivolgersi. Un esempio rende l’idea concreta. Se gli si chiede di sviluppare una pagina web, il risultato potrebbe nascere per il sessanta per cento dal lavoro di Claude Opus 4.8 e per il restante quaranta per cento da GPT 5.5. Su una domanda di conoscenza generale la ripartizione potrebbe spostarsi, con metà del contributo affidato a Gemini, il quaranta per cento a Claude e il dieci per cento a GPT. È il principio secondo cui l’unione fa la forza, applicato in modo sistematico.
A rendere credibile la scommessa contribuiscono la storia dell’azienda, fondata a Tokyo nel 2023 da Llion Jones, coautore del paper “Attention Is All You Need” che ha dato origine ai transformer, e da David Ha, ex responsabile della ricerca di Stability AI, e soprattutto due paper scientifici in cui Sakana descrive nel dettaglio il funzionamento dell’orchestratore, entrambi accettati a conferenze internazionali. Non si tratta quindi soltanto di marketing, ma di un approccio documentato che rende plausibili i numeri dichiarati, quelli per cui Fugu supera Opus 4.8 e arriva a sfiorare i modelli più recenti pur non possedendo, di per sé, alcuna intelligenza superiore. Sakana propone infatti due versioni, una standard ottimizzata per la latenza bassa nei compiti quotidiani e una, Fugu Ultra, dedicata ai problemi complessi che richiedono ragionamento multi-step, ed è proprio confrontando queste varianti con i modelli di frontiera che emergono i risultati più interessanti.
La logica dei rendimenti decrescenti
C’è un’ipotesi implicita in questo approccio che merita di essere esplicitata, ovvero che aggiungere potenza computazionale produca rendimenti decrescenti. Per anni il progresso è avanzato principalmente lungo una dimensione, quella della scala, con modelli più grandi, dataset più ampi e infrastrutture più potenti che producevano sistemi migliori in modo abbastanza prevedibile. Quella traiettoria sta mostrando i suoi limiti, non perché non si possano addestrare modelli più grandi, ma perché il costo marginale di ogni ulteriore miglioramento cresce mentre il beneficio marginale diminuisce. Se questo è vero, il vantaggio competitivo si sposta, e non conta più soltanto chi costruisce il cervello più potente ma chi riesce a coordinare meglio i cervelli disponibili. Internet non ha trionfato perché era il computer più potente, ha trionfato perché era una rete, e il modo in cui i nodi erano connessi produceva qualcosa di qualitativamente diverso da qualunque macchina centralizzata dell’epoca.
Il parallelo con le organizzazioni umane
Lo stesso meccanismo si manifesta nelle aziende. Chi costruisce un’organizzazione vincente raramente lo fa trovando il singolo dipendente più brillante sul mercato, lo fa costruendo sistemi in cui molte persone competenti coordinano il proprio lavoro in modo efficace, riducono le attività di attrito, si specializzano dove il contributo è più prezioso e si integrano con gli altri dove la specializzazione da sola non basta. Il risultato complessivo supera la somma dei contributi individuali non grazie alla qualità media dei singoli ma grazie alla qualità del coordinamento tra loro. Fugu porta questa logica nell’intelligenza artificiale in modo esplicito, proponendo una domanda diversa da quella consueta, ovvero quale sistema di coordinamento produca i risultati migliori dato un insieme di modelli già capaci.
Costi, tempi e la mossa di marketing
Coordinare più modelli ha un prezzo, in senso letterale. Sakana offre Fugu con piani mensili oppure tramite API, dove il costo dichiarato è di circa cinque dollari per milione di token in input e trenta in output. La cifra è più alta di quella di molti modelli singoli per una ragione strutturale, perché chi usa Fugu paga Fugu, che a sua volta paga i modelli chiusi che interpella. Anche i tempi si allungano, perché interrogare più modelli e sintetizzarne le risposte rende la generazione più lenta e più costosa, in cambio di un output di qualità superiore. Sul piano comunicativo la mossa è stata brillante, perché molti hanno parlato di un modello che batte tutti senza accorgersi che si trattava di un orchestratore da sette miliardi di parametri, e nel frattempo il Giappone si è posizionato di colpo tra i protagonisti della frontiera.
Una domanda aperta sul futuro
Rimane aperta la questione più rilevante, quella sulla direzione in cui il campo si muoverà nel medio periodo. Se l’orchestrazione diventa la leva principale di progresso, il futuro dell’intelligenza artificiale potrebbe assomigliare sempre meno a un genio solitario capace di risolvere qualunque problema e sempre più a una squadra di sistemi specializzati che si coordinano per affrontare ciò che nessuno di loro riuscirebbe ad affrontare da solo. Quella transizione non avverrà in modo netto, i modelli monolitici continueranno a migliorare e i sistemi di orchestrazione continueranno a dipendere da loro, ma la direzione in cui Sakana sta scommettendo è quella in cui il valore sta nella connessione più che nella potenza dei singoli nodi.
Per saperne di più: https://sakana.ai/fugu/